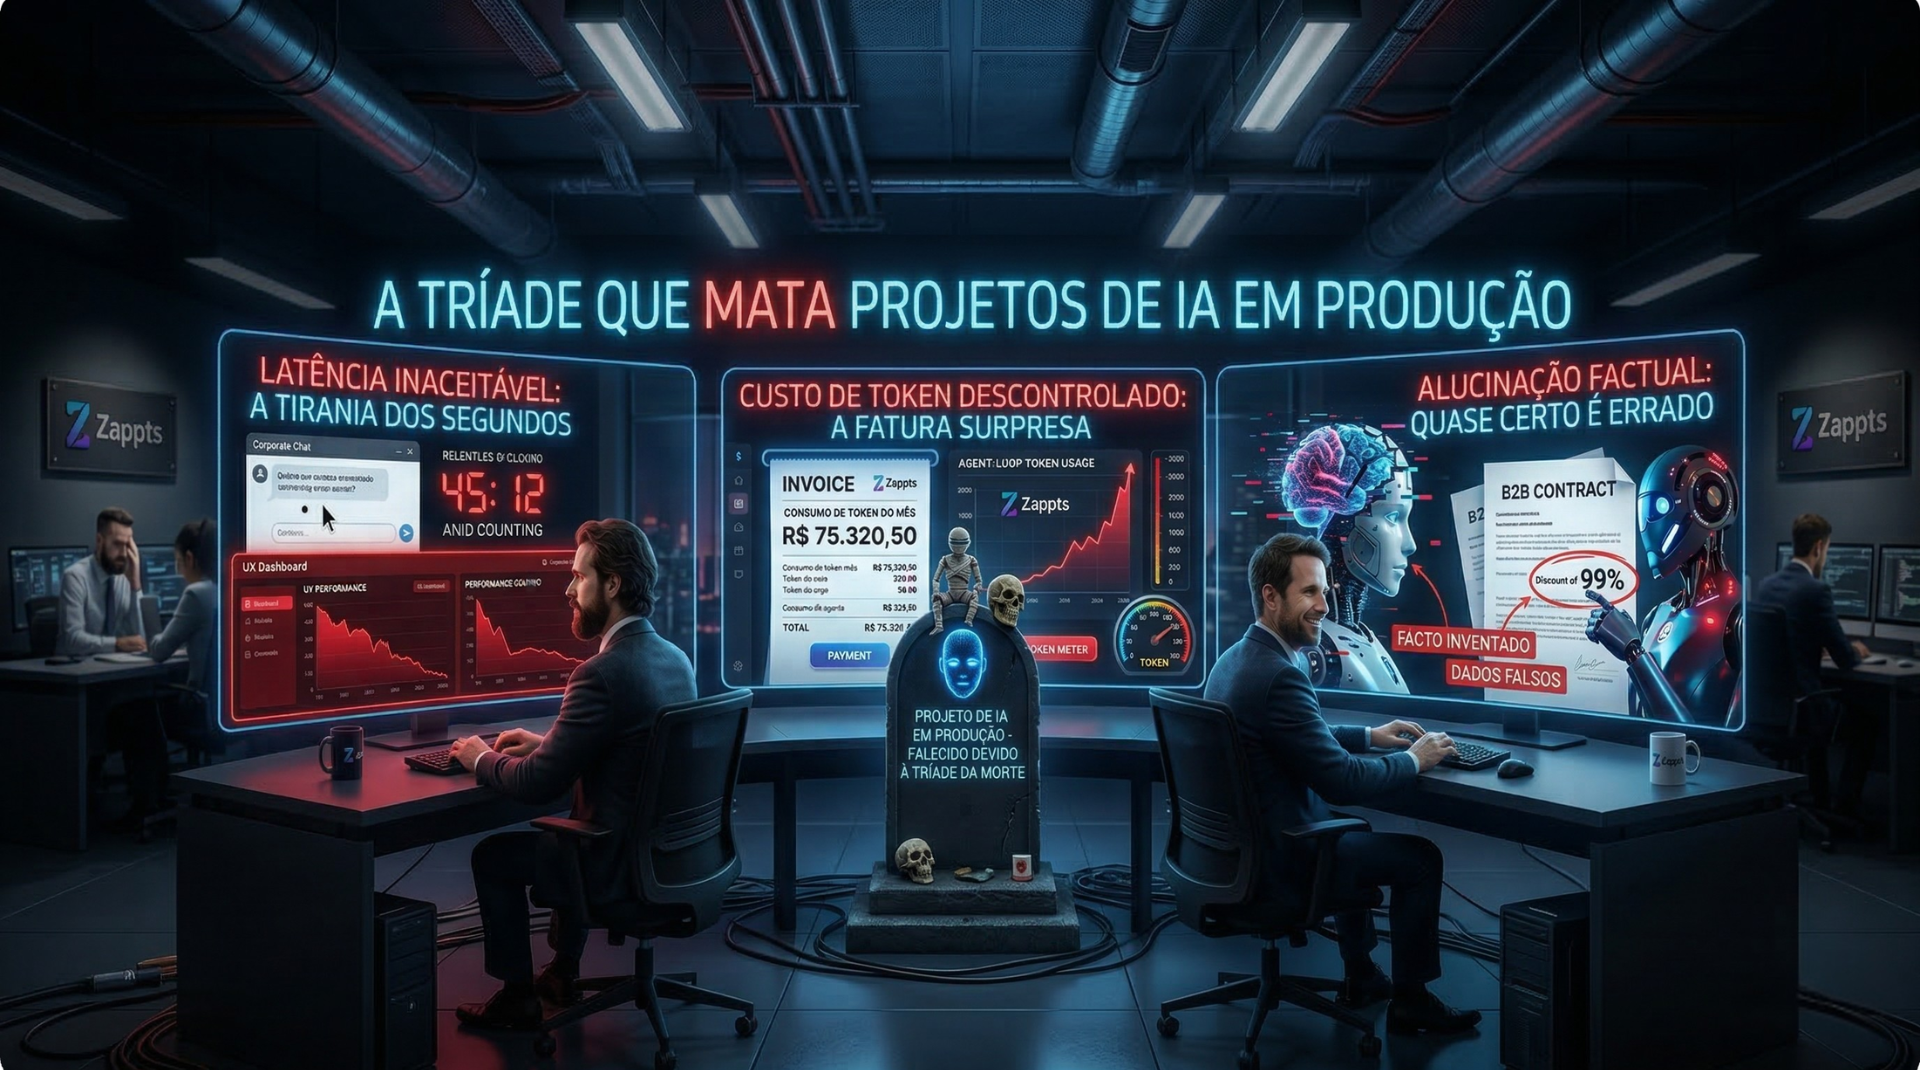
Latencia, Costo y Alucinación: La Tríade que Mata Proyectos de IA en Producción
Latencia, Costo y Alucinación: La Tríade que Mata Proyectos de IA en Producción Resumen, Tesis Central, Principales Insights y Recomendaciones Estratégicas Resumen Muchas iniciativas de IA funcionan perfectamente en entornos de pruebas pero colapsan en la primera semana de operación real. Este artículo disecciona la "Tríade de la Muerte" — Latencia inaceptable, Costo de token descontrolado y Alucinación factual — y presenta estrategias de ingeniería para mitigar estos riesgos, transformando [...]
18 de março de 2026
Resumen, Tesis Central, Principales Insights y Recomendaciones Estratégicas
Resumen
Muchas iniciativas de IA funcionan perfectamente en entornos de pruebas pero colapsan en la primera semana de operación real. Este artículo disecciona la “Tríade de la Muerte” — Latencia inaceptable, Costo de token descontrolado y Alucinación factual — y presenta estrategias de ingeniería para mitigar estos riesgos, transformando juguetes experimentales en aplicaciones de misión crítica.
Tesis Central: Desplegar un LLM en producción no es un desafío de Data Science, es un desafío de Ingeniería de Sistemas Distribuidos. Sin una arquitectura que contemple Caché Semántico, Enrutamiento de Modelos (Model Routing) y Guardrails Determinísticos, la experiencia del usuario será lenta, el costo prohibitivo y la confiabilidad nula.
Principales Insights:
- La Tiranía de los Segundos: Los usuarios corporativos toleran esperar por un reporte complejo, pero no toleran esperar 15 segundos para una respuesta de chat. La latencia (Time-to-First-Token) es el nuevo KPI de UX.
- La Factura Sorpresa: El modelo de cobro por token transforma códigos mal optimizados en hemorragias financieras. Un loop de agente mal diseñado puede consumir el presupuesto del mes en horas.
- La Precisión es Binaria: En B2B, “casi correcto” es “incorrecto”. Un RAG (Retrieval-Augmented Generation) mal implementado aumenta la confianza de la IA en la mentira, en vez de corregir el hecho.
Recomendaciones Estratégicas:
- Implementar agentes especialistas que realizan tareas estándar y menores en lugar de agentes generalistas que resuelven todo tipo y cualquier tamaño de problema.
- Implementar estrategias de Model Routing: usar modelos baratos y rápidos (ej: GPT-4.1-mini, Haiku) para tareas simples y reservar los modelos caros (GPT-4.1, GPT-5, Opus) solo para razonamiento complejo.
- Adoptar Caché Semántico para evitar pagar dos veces por la misma pregunta frecuente.
- Establecer Pruebas de Regresión en IA (Evals) automatizadas antes de cada deploy.
Contexto y Problema de Negocio
En el laboratorio de innovación, con un solo usuario probando, la IA parece magia. El CEO hace una pregunta, el cursor parpadea, y 10 segundos después aparece una respuesta brillante. El costo de esa interacción? Irrisorio, fracciones de centavos.
Entonces, el proyecto va a producción (Go-Live). De repente, 5.000 colaboradores acceden simultáneamente. La API de OpenAI se atasca. El tiempo de respuesta sube a 45 segundos. La factura de la tarjeta corporativa se dispara porque los usuarios están pegando documentos de 500 páginas para resumir. Y peor: la IA comienza a inventar descuentos que no existen.
Este escenario es el estándar de la industria hoy. Según datos de nuestro estudio Panorama de la IA en Brasil, el 41% de las empresas citan “Costos” como la barrera principal, muchas veces descubierta tarde, para el uso de la IA en sus empresas. La ingeniería de software tradicional no preparó a los equipos para lidiar con sistemas no determinísticos y costosos.
Impulsores de Mercado: La Física de la IA a Escala
Tres fuerzas físicas actúan contra el éxito de su aplicación:
- Latencia de Red e Inferencia: Los LLMs generan texto palabra por palabra. Cuanto más compleja la respuesta, mayor la espera. En aplicaciones de atención al cliente, cada segundo de retraso reduce la satisfacción (CSAT) en un 15% (Akamai).
- Economía de Tokens: A diferencia de un servidor SQL donde paga por capacidad fija, en la IA paga por uso. Un prompt “perezoso” que envía todo el historial de la conversación en cada interacción es financieramente irresponsable.
- Naturaleza Probabilística: El software tradicional es lógico (Si A, entonces B). La IA es probabilística (Probablemente B, pero tal vez C). En finanzas y salud, “tal vez” es inaceptable.
Análisis Estratégico: Ingeniería de Defensa
En Zappts, tratamos la IA como sistemas de alto rendimiento. Para combatir la tríade, aplicamos técnicas específicas:
1. Combatiendo la Latencia (Optimización de UX): No muestre solo un “spinner” girando. Use Streaming Responses. Tan pronto como la IA genera la primera palabra, muéstrela al usuario. Esto reduce la latencia percibida de 10s a 0.5s. Además, use Caché Semántico: si alguien ya preguntó “¿Cómo emito una factura?” hoy, el sistema no debe llamar a la IA de nuevo; debe entregar la respuesta guardada instantáneamente (Costo Cero, Latencia Cero).
2. Combatiendo el Costo (Model Routing): No toda pregunta exige un genio. Si el usuario dice “Hola”, no necesita GPT-5 (que es caro). Un modelo menor resuelve eso por 1% del precio. Prefiera construir agentes especialistas en lugar de grandes agentes generalistas. Utilice “Enrutadores de IA” que clasifican la complejidad de la pregunta y eligen el modelo más barato capaz de resolverla.
3. Combatiendo la Alucinación (Grounding & Evals): La IA solo debe responder con base en los documentos que usted proporcionó. Usamos técnicas avanzadas de RAG (Retrieval-Augmented Generation) con citación obligatoria de fuentes. Si la IA no encuentra la respuesta en el documento oficial, está programada para decir “No sé”, en vez de inventar.
Implicaciones para las Organizaciones
Ignorar la ingeniería detrás del prompt resulta en:
- Abandono de la Herramienta: Si la IA es más lenta que buscar en la Intranet, nadie la usa.
- Hemorragia de Opex: Proyectos que empiezan costando R$ 5 mil/mes pueden saltar a R$ 50 mil/mes sin aviso previo si no hay monitoreo de tokens.
- Riesgo Legal: Una alucinación en un contrato o política de compliance puede invalidar procesos jurídicos.
Recomendaciones para CTOs y Directores de Ingeniería
Para el Director de Ingeniería y el CTO:
- Exija Métricas de Observabilidad: Tiene dashboards de CPU y Memoria. Ahora necesita dashboards de Latencia por Token, Costo por Sesión y Tasa de Alucinación. Lo que no se mide rompe el presupuesto.
- Adopte Small Language Models (SLMs): El futuro es ejecutar modelos pequeños y especializados y, eventualmente, dentro de su propia infraestructura (On-Premise o Private Cloud), reduciendo drásticamente costos y latencia de red.
- Pruebe como Software, no como Magia: Cree pipelines de CI/CD para IA. Cada vez que cambia un prompt, un script debe ejecutar 100 preguntas de prueba y verificar si la precisión bajó.
- Limite el Contexto: No envíe documentos enteros si solo un párrafo es relevante. Optimizar la recuperación (búsqueda) es más barato que pagar por el procesamiento (generación).
Conclusión
Desplegar IA en producción es fácil. Mantener IA en producción con ganancias y rendimiento es difícil. La diferencia entre una POC fallida y un Caso de Éxito generalmente no está en la calidad de la idea, sino en la robustez de la ingeniería que la sustenta. No deje que la latencia, el costo o la alucinación mantengan su innovación en la cuna.
En el próximo artículo exploraremos una de las técnicas vitales para el éxito de la implementación: la orquestación de pequeños agentes especializados.
Sobre el Autor
Rodrigo Bornholdt es Co-fundador y Chief Technology Officer de Zappts, especializado en Arquitectura de Software e Inteligencia Artificial, con sólida experiencia en liderazgo de equipos de tecnología, desarrollo de sistemas complejos e innovación aplicada a estrategias de negocio.
Sobre Zappts
Zappts es la consultora líder en transformación agéntica en Brasil, ayudando a las empresas a evolucionar de lo digital a lo agéntico. Con más de 10 años, Zappts crea, moderniza y evoluciona soluciones digitales seguras y escalables para grandes organizaciones. Combinando experiencia práctica en ingeniería de software, datos e inteligencia artificial, integra tecnología, metodología y procesos, acelerando la entrega de valor con eficiencia, calidad y gobernanza. Su actuación va desde la estrategia hasta el desarrollo de aplicaciones de software y agentes de IA, siendo referencia en Brasil en el tema de agentes de inteligencia artificial. Haga clic aquí para saber más.
Comparte este artículo
Artículos relacionados
16 set 2026
El fin del SaaS pasivo: por qué pagarás por resultados, no por usuarios.
El modelo tradicional de precios de software basado en licencias por usuario (SaaS basado en puestos) se enfrenta a un declive inevitable para 2026.
09 set 2026
El dilema de la autonomía tímida: por qué limitar la IA a sugerir información está mermando su margen de beneficio.
Este artículo analiza el impacto financiero de esta "autonomía tímida" y aboga por la evolución urgente hacia el modelo "Human-on-the-loop" (HOTL, por sus siglas en inglés).
02 set 2026
"SaaSocalypse" es, de hecho, una crisis de arquitectura e identidad.
Este artículo realiza un análisis retrospectivo de una historia de éxito real (anonimizada) en el sector financiero, diseccionando las capas de...